Quando la comunicazione smette di studiare il pubblico e comincia ad anticiparlo
di Giampiero Posa
Per buona parte della storia della pubblicità, conoscere il pubblico significava cercare di scoprire chi ci fosse dall’altra parte del messaggio: studiavamo, chiedevamo, osservavamo, ricercavamo e sviluppavamo strategie. Era indispensabile conoscere le abitudini di consumo, le preferenze, le età, i luoghi in cui vivevano le persone e, soprattutto, ciò che poteva rendere una determinata proposta rilevante per loro.
La pubblicità lavorava per approssimazioni, costruiva profili e cercava di trovare una spiegazione alle decisioni umane, ma qualcosa rimaneva fuori dalla nostra portata: il momento esatto in cui una persona cambiava idea, il motivo per cui un’immagine riusciva a catturare la sua attenzione e l’istante in cui una ricerca apparentemente innocente finiva per trasformarsi in un acquisto.
Per decenni, la comunicazione dovette accontentarsi di studiare le tracce lasciate dalle persone dopo aver agito, finché arrivò internet e cambiò questo rapporto.
Un tempo, una campagna pubblicitaria rimaneva esattamente uguale per settimane; l’annuncio veniva creato, approvato, stampato o trasmesso e infine presentato al pubblico, per poi iniziare l’attesa. Le agenzie potevano misurare le vendite, realizzare studi successivi o chiedere che cosa avesse prodotto una campagna, ma il messaggio era già stato lanciato.
Erano processi caratterizzati da una certa rigidità: il marchio parlava, il pubblico rispondeva e, successivamente, gli specialisti cercavano di interpretare quella risposta.
La comunicazione, in sostanza, era un processo relativamente lineare: prima si studiava il pubblico, poi si costruiva il messaggio, quindi lo si diffondeva e infine si analizzavano i risultati.
Ma internet ha cambiato questa dinamica.
Ogni volta che qualcuno cerca qualcosa, abbandona una pagina, rimane per alcuni secondi davanti a un contenuto, torna su un’immagine, cambia una parola, riproduce un video o decide di non farlo, lascia una traccia che dice molto poco; ma milioni di tracce, osservate per un lungo periodo, cominciano a raccontare una storia molto precisa.
La rivoluzione digitale ha creato la possibilità che la risposta modificasse immediatamente il messaggio: una fotografia può funzionare meglio di un’altra, un determinato contenuto può ottenere maggiore interazione, la durata di un video può trattenere il pubblico più a lungo e, infine, un annuncio può funzionare su una persona e fallire completamente su un’altra.
La comunicazione ha cominciato così a trasformarsi in un processo di prova permanente.
La pubblicità non doveva più necessariamente aspettare la fine di una campagna per sapere cosa avesse funzionato; poteva osservare la risposta mentre la campagna era in corso e utilizzare quelle informazioni per modificare ciò che sarebbe venuto dopo.
A questa trasformazione si è aggiunta l’intelligenza artificiale, che ha nuovamente ridimensionato il modo di comunicare.
Nei miei articoli precedenti ho cercato di seguire questa trasformazione da diverse angolazioni.
Ne “Il design della distrazione” parlavo di come le interfacce abbiano smesso di limitarsi a organizzare le informazioni e abbiano cominciato a partecipare all’organizzazione della nostra attenzione; uno schermo non è più soltanto una superficie sulla quale appare un contenuto; il suo design può determinare ciò che accade dopo che qualcosa riesce a catturare il nostro sguardo.
Ne “La fabbrica della felicità” descrivo come il passo successivo sia stato osservare il modo in cui la pubblicità ha imparato a lavorare con le emozioni e come le piattaforme digitali potessero trasformare quelle emozioni in segnali capaci di alimentare nuovi processi di personalizzazione.
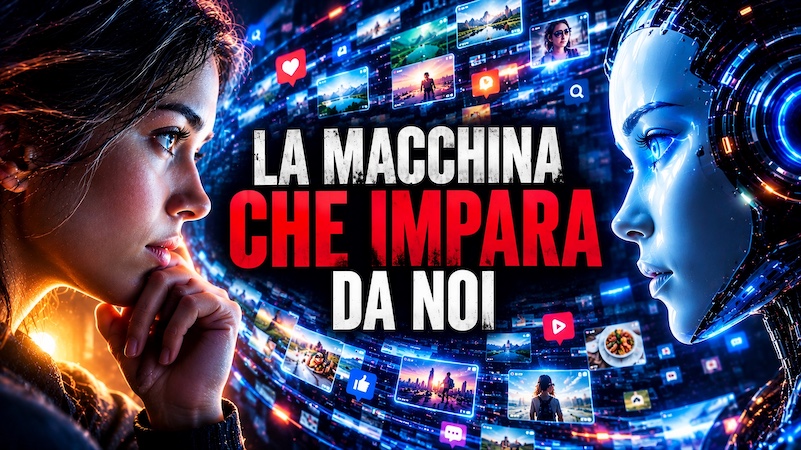
Ora appare una terza trasformazione: la macchina non vuole soltanto la nostra attenzione né cerca unicamente di provocare un’emozione. Sta imparando dalla nostra risposta.
La sequenza può essere riassunta in: Attenzione – Emozione – Fiducia – Predizione.
La sequenza non è casuale: ogni fase approfondisce un po’ di più il rapporto tra comunicazione ed essere umano: prima bisognava ottenere che guardassimo; poi, che provassimo qualcosa; successivamente, che credessimo; e ora comincia a essere possibile cercare di anticipare ciò che faremo dopo.
Non si tratta più soltanto di sapere cosa vuole la gente, ma di cercare di anticipare ciò che farà, e in questo spostamento si trova una delle trasformazioni più profonde che la comunicazione contemporanea sta vivendo.
Perché quando una macchina impara dal nostro comportamento, il rapporto tra chi comunica e chi riceve il messaggio smette di essere completamente unidirezionale.
Noi osserviamo la comunicazione, ma la comunicazione ha cominciato anche a osservarci; in realtà, mi riferisco alle risposte delle persone che vi accedono.
I sistemi di raccomandazione contemporanei non dipendono soltanto da regole semplici: utilizzano tecniche di apprendimento automatico e grandi quantità di informazioni per mettere in relazione i comportamenti e generare previsioni su ciò che potrebbe risultare rilevante per ciascun utente.
Una revisione accademica pubblicata da Springer Nature nel 2026 sui sistemi di raccomandazione basati sull’intelligenza artificiale descrive precisamente la convergenza tra personalizzazione, comportamento del consumatore, analisi predittiva ed esperienza dell’utente.
La parola importante è predittiva, perché raccomandare non significa soltanto mostrare qualcosa che coincide con i nostri interessi; significa formulare un’ipotesi sul nostro prossimo movimento, e questo cambia profondamente la natura della comunicazione.
Quando una persona cerca un prodotto, esiste un’intenzione relativamente evidente: ha formulato una domanda e si aspetta di trovare una risposta, ma la tecnologia attuale cerca di andare oltre quella domanda; osserva ciò che è accaduto prima, ciò che è avvenuto dopo, mette in relazione i comportamenti, confronta i modelli, impara da milioni di persone che hanno compiuto azioni simili e costruisce una possibilità.
Non ha bisogno di sapere con assoluta certezza cosa farà una persona: è sufficiente stimare quale comportamento abbia maggiori probabilità di verificarsi, ed è qui che emerge un’idea che per molto tempo è appartenuta più alla fantascienza che alla pubblicità: la comunicazione può cominciare ad arrivare prima della decisione.
Per decenni, convincere significava intervenire su una decisione che stava avvenendo. Ora, una parte dell’industria digitale cerca di intervenire nel percorso che conduce a quella decisione; non aspetta necessariamente che emerga il bisogno; cerca segnali che indichino che il bisogno potrebbe stare emergendo.
Questa differenza spiega buona parte del nuovo rapporto che manteniamo con le piattaforme digitali.
Ogni reazione diventa informazione per la comunicazione successiva e ogni risultato modifica l’ipotesi successiva, costruendo in questo modo un circuito nel quale la persona agisce, il sistema registra, la macchina impara, il sistema modifica ciò che mostra, la persona reagisce nuovamente e il processo ricomincia ancora e ancora.
La vera novità non sta nel fatto che un computer possa raccomandare un film o un prodotto; ciò che è interessante è che la comunicazione comincia a comportarsi come un sistema che impara continuamente dalle conseguenze dei propri messaggi.
Le campagne hanno smesso di essere completamente statiche perché il pubblico smette di essere soltanto pubblico e diventa una fonte permanente di informazioni.
Questa trasformazione ha una conseguenza che merita più attenzione di quanta ne riceva: per molto tempo, la ricerca pubblicitaria ha cercato di scoprire ciò che le persone dicevano di volere, ma il problema era evidente: ciò che dichiariamo di noi stessi non sempre coincide con ciò che facciamo.
Possiamo affermare di preferire determinati marchi e finire per comprarne altri; dire di voler trascorrere meno tempo davanti al telefono e continuare a scorrere lo schermo; assicurare che un determinato tipo di contenuto non ci interessa e, tuttavia, fermarci ripetutamente quando appare.
Il comportamento digitale non ha bisogno di chiederci cosa abbiamo fatto, perché può osservarlo.
Alla luce di ciò, sarebbe difficile affermare che le macchine ci conoscano perfettamente: sarebbe un’esagerazione. I dati rappresentano sempre soltanto una parte della realtà e un comportamento digitale può avere molte interpretazioni, ma ciò significa che le aziende dispongono di una quantità di informazioni comportamentali che le generazioni precedenti di pubblicitari non avevano.
La ricerca sull’intelligenza artificiale e sul comportamento del consumatore pubblicata da ScienceDirect.com nel 2026 evidenzia precisamente questa relazione tra personalizzazione, fiducia e preoccupazioni legate alla privacy negli ambienti dei social network.
Il paradosso è che ciò che rende una comunicazione più utile può anche renderla più inquietante; quanto più rilevante appare un messaggio, tanto più evidente può risultare che qualcuno — o qualcosa — ha imparato da noi.
C’è un momento particolarmente interessante in questa trasformazione: quello in cui la personalizzazione smette di essere percepita come utile e comincia a sembrare troppo precisa.
La personalizzazione ha una frontiera psicologica: finché sentiamo che una tecnologia ci aiuta, la accettiamo facilmente; ma quando cominciamo a sentire che ci sta osservando, il nostro rapporto con essa cambia.
E quando, inoltre, non comprendiamo come sia arrivata a una determinata conclusione, emerge un problema ancora più profondo: smettiamo di sapere fino a che punto stiamo utilizzando uno strumento e fino a che punto stiamo entrando in un ambiente progettato intorno alle nostre stesse risposte.
Vogliamo che la tecnologia ci conosca abbastanza da aiutarci, ma non necessariamente così tanto da farci sentire che abbia cominciato a definirci.
La pubblicità ha sempre cercato di trovare il messaggio giusto; ciò che è cambiato è la velocità con cui può riuscirci. In precedenza, in un’agenzia avremmo sviluppato diverse versioni di una campagna e deciso quale utilizzare; ora un sistema può lavorare con enormi quantità di varianti e osservarne i risultati praticamente in modo continuo.
L’intelligenza artificiale accelera ancora di più questo processo perché permette di generare, confrontare e adattare contenuti su una scala che sarebbe difficile da gestire esclusivamente attraverso il lavoro umano, ed è qui che emerge una questione che non appartiene soltanto alla tecnologia, ma anche alla comunicazione.
Se un sistema può imparare quale tipo di immagine riesce a trattenere più a lungo la nostra attenzione, quale tono provoca una maggiore risposta o quale argomento aumenta la possibilità di una determinata azione, la domanda non è più soltanto se lo strumento funziona, ma diventa: per cosa utilizza quello strumento la conoscenza che ha acquisito?
Conoscere meglio il pubblico può permettere di costruire messaggi più chiari, meno invasivi e più utili, ma la stessa conoscenza può essere utilizzata per individuare vulnerabilità, sfruttare impulsi o ridurre deliberatamente la distanza tra un’intenzione commerciale e una decisione.
La tecnologia non determina da sola quale di queste strade verrà seguita; almeno per il momento, quella decisione continua a essere umana e, proprio per questo, anche la responsabilità continua a essere umana.
Il quadro di gestione del rischio dell’intelligenza artificiale del NIST insiste sul fatto che i sistemi di IA richiedono di considerare questioni come trasparenza, privacy, spiegabilità, bias, supervisione e responsabilità umane durante tutto il loro ciclo di vita; avverte inoltre che trasformare fenomeni umani complessi in variabili misurabili può significare perdere parte del contesto necessario per comprenderne gli effetti.
È un’osservazione particolarmente importante per la comunicazione, perché una persona non è mai completamente riducibile ai propri dati.
Un algoritmo può sapere che qualcuno acquista abitualmente determinati prodotti, rilevare che una persona risponde meglio a certi formati e riconoscere modelli di comportamento simili a quelli di milioni di utenti. Può, in conclusione, calcolare probabilità.
Ma una probabilità non è una persona, e questo costituisce uno dei rischi culturali più interessanti della nuova comunicazione.
Quando una macchina riesce a prevedere determinati comportamenti con sufficiente precisione, nasce la tentazione di cominciare a interpretare l’essere umano attraverso ciò che può essere misurato; ciò che non appare nei dati comincia a perdere importanza.
La contraddizione è che alcune delle decisioni più importanti della nostra vita nascono proprio da ciò che è difficile da quantificare.
Il problema emerge quando confondiamo la capacità di prevedere un comportamento con la capacità di comprendere la persona che lo compie; sono cose molto diverse. L’intelligenza artificiale introduce, inoltre, un altro cambiamento silenzioso: le macchine non imparano soltanto da noi; anche noi impariamo dalle macchine.
Ogni raccomandazione modifica ciò che vediamo, ciò che vediamo influenza ciò che consideriamo possibile, interessante o rilevante, e questo modifica le nostre decisioni, che finiscono nuovamente per alimentare il sistema, creando così una relazione circolare.
L’algoritmo impara dal nostro comportamento, ma partecipa anche alla costruzione dell’ambiente nel quale quel comportamento avviene; questo cambia il modo di comprendere la personalizzazione, perché non siamo più davanti a uno specchio completamente neutrale che riflette semplicemente i nostri interessi, ma davanti a un sistema che seleziona quale parte del mondo mostrarci e lascia fuori dallo schermo qualcosa che potrebbe avere anch’esso importanza.
Una raccomandazione non dice soltanto: “Questo potrebbe interessarti”; sta anche dicendo, implicitamente: “Questo è ciò che merita di comparire davanti a te adesso”.
Per molto tempo abbiamo vissuto la pubblicità come una competizione per spazi limitati: una pagina di giornale aveva un determinato numero di annunci, una rivista aveva un certo numero di pagine, la televisione aveva determinati minuti e la radio determinati blocchi.
Il problema ha smesso di essere quanto contenuto potesse essere prodotto ed è diventato quale contenuto dovesse ricevere ogni persona; quando il volume delle informazioni cresce fino a livelli che nessun essere umano può elaborare autonomamente, emerge inevitabilmente la necessità di selezionare, ed è qui che entrano in gioco gli algoritmi.
Non possono mostrarci tutto, quindi devono decidere cosa appare per primo.
La personalizzazione emerge allora non soltanto come uno strumento commerciale, ma come una risposta a un problema reale di abbondanza: ci sono troppi film, notizie, canzoni, prodotti, video e fotografie; e tra questi esiste anche un’enorme possibilità di menzogne.
I computer cercano di ridurre questo eccesso e, nel farlo, acquisiscono una funzione che prima apparteneva principalmente a editori, giornalisti, programmatori, curatori, librai, critici e altri intermediari umani: decidere cosa merita la nostra attenzione. E questo merita di essere osservato con attenzione, perché quando la scarsità di informazioni scompare, la risorsa scarsa torna a essere l’attenzione.
Chi partecipa alla selezione di ciò che riceve la nostra attenzione partecipa anche, seppure indirettamente, alla costruzione della nostra esperienza quotidiana; questo si collega nuovamente al problema che ho affrontato ne “Il design della distrazione”.
Se prima parlavamo di interfacce capaci di mantenere la nostra attenzione, ora osserviamo sistemi capaci di imparare quale tipo di stimolo funziona meglio con ogni persona.
La comunicazione smette di essere completamente di massa e diventa progressivamente individuale.
Le campagne cominciano a comportarsi meno come un contenuto finito e più come un organismo che si adatta; l’intelligenza artificiale non crea necessariamente un messaggio perfetto, ma crea la possibilità di cercarlo continuamente.
Fino a che punto dovrebbe arrivare questo adattamento?
Perché quanto più un sistema conosce le nostre preferenze, tanto più facile diventa comunicare con noi, ma può anche diventare più facile influenzarci.
Il confine tra personalizzazione e persuasione diventa sempre più sottile.
È importante, tuttavia, sottolineare che non tutta la persuasione è manipolazione.
Persuadere fa parte della comunicazione umana, la pubblicità ha sempre cercato di persuadere; la comunicazione politica persuade; il giornalismo cerca di convincere il lettore dell’importanza di determinati fatti; le campagne sociali cercano di modificare i comportamenti.
Il problema emerge quando la persona smette di avere una comprensione ragionevole di come si sta producendo quell’influenza; quando il messaggio si adatta costantemente alle nostre vulnerabilità; quando la selezione dei contenuti diventa opaca; e quando il sistema può sperimentare su larga scala senza che l’utente sappia realmente cosa si sta ottimizzando.
La tecnologia rende la comunicazione più rilevante, ma la rilevanza non deve diventare automaticamente una licenza per influenzare senza limiti; per questo, la vera sfida dell’intelligenza artificiale nella comunicazione non consiste soltanto nell’imparare a utilizzare nuovi strumenti, ma nell’imparare cosa fare con la conoscenza che quegli strumenti forniscono.
La differenza non sta soltanto nell’algoritmo, ma nell’intenzione, nel design, nelle regole e nelle decisioni umane che circondano l’algoritmo; per questo, i modelli di gestione responsabile dell’IA non attribuiscono tutta la responsabilità alla tecnologia.
Il NIST (National Institute of Standards and Technology) considera la gestione del rischio come un processo continuo che coinvolge governance, identificazione, misurazione e gestione lungo tutto il ciclo di vita dei sistemi; questa idea dovrebbe essere trasferita anche al mondo della comunicazione, perché una campagna non diventa responsabile semplicemente perché utilizza uno strumento sofisticato.
La sofisticazione tecnologica non sostituisce il criterio.
Un altro aspetto paradossale di tutto questo è che la tecnologia sta rendendo più facile che mai conoscere un pubblico, ma, allo stesso tempo, comprendere le persone potrebbe diventare più difficile; abbiamo più dati, ma non necessariamente più comprensione; maggiore capacità di misurare, ma non necessariamente maggiore capacità di interpretare; più possibilità di personalizzare, ma anche più possibilità di rinchiudere ogni persona dentro ciò che già sappiamo di lei, e questo è uno dei grandi rischi culturali della personalizzazione estrema.
Se una macchina impara che ci piacciono determinate cose, può mostrarcene sempre di più; l’esperienza potrebbe sembrare diventare più comoda, ma una vita completamente personalizzata potrebbe trasformarsi anche in una vita con meno scoperte e maggiore controllo sociale.
Gli algoritmi imparano dal nostro passato, ma quanto spazio lasciano al nostro futuro?
Le persone non siamo soltanto ciò che abbiamo fatto, siamo anche ciò che ancora non abbiamo fatto, ciò che possiamo cambiare, scoprire e ciò che ancora può sorprenderci; per questo, nessuna previsione dovrebbe trasformare il nostro comportamento passato in una condanna sul nostro comportamento futuro.
Sottolineo che la risposta non dovrebbe essere il rifiuto della tecnologia; sarebbe assurdo e probabilmente poco desiderabile, poiché i sistemi di raccomandazione possono aiutarci a trovare qualcosa tra milioni di opzioni; la personalizzazione può ridurre la quantità di informazioni irrilevanti; e l’intelligenza artificiale può contribuire a creare comunicazioni più accessibili, comprendere le esigenze e adattare i contenuti a pubblici differenti.
Il problema non sta nel fatto che la macchina impari, ma in ciò che accade quando smettiamo di chiederci cosa sta imparando, da dove proviene questo apprendimento e quali decisioni prendiamo a partire da esso, perché dietro ogni modello esistono decisioni umane.
Qualcuno ha deciso quali dati utilizzare, quale comportamento misurare, quale risultato debba essere considerato un successo, quale debba essere ottimizzato e cosa fare quando il sistema ottiene ciò che gli è stato chiesto.
La macchina può calcolare; la responsabilità, ancora, non può essere completamente delegata.
Dobbiamo ricordare, inoltre, che la capacità di previsione non equivale alla capacità di comprensione.
Un computer può riconoscere schemi, stabilire relazioni e calcolare probabilità con una velocità straordinaria, ma esiste ancora una differenza fondamentale tra prevedere un comportamento e comprendere l’essere umano che decide di compierlo.
Qui appare la vera sfida.
Il futuro della comunicazione non apparterrà esclusivamente a coloro che sapranno utilizzare meglio l’intelligenza artificiale, apparterrà anche a coloro che comprenderanno meglio l’essere umano che rimane dietro i dati.
Il vero vantaggio non sta nel produrre più messaggi; l’intelligenza artificiale sta già rendendo sempre più semplice produrre contenuti. Il vantaggio sarà sapere quando un messaggio merita di esistere, quando una personalizzazione aiuta e quando invade, così come riconoscere quando una previsione serve a facilitare una decisione e quando comincia a cercare di sostituirla.
I computer e i sistemi imparano da noi: dai nostri percorsi, dalle nostre scelte, dalle nostre pause, dalle nostre risposte e da ciò che rifiutiamo; ogni giorno diventano più bravi a riconoscere gli schemi.
Ma anche noi stiamo imparando a vivere all’interno di sistemi che ci raccomandano, classificano, anticipano e mostrano una versione personalizzata del mondo che non è necessariamente quella ideale.
La sfida delle prossime generazioni di comunicatori non sarà fare in modo che la tecnologia conosca ancora di più le persone, ma riuscire a fare in modo che, mentre le conosce, non smetta di rispettare la loro capacità di cambiare.
Perché un computer può probabilmente sapere cosa faremo domani, ma tra una previsione e una decisione esiste uno spazio piccolo, invisibile e profondamente umano chiamato libertà di scegliere e, finché esisterà, l’ultima parola su ciò che faremo dopo, quell’ultima parola, continuerà a non appartenere ai computer e ai sistemi.